 Gugugu Lab
研究
PsyML Toolkit
从心理学学习和行为数据分析中逐渐发展起来的本地科研工具。
已有公开版本 · Apple 芯片 Mac 与 Windows x64
最新版本: v0.3.0

为什么做这个项目
我最早在学习心理学和分析行为数据时接触到机器学习。本科阶段,我写代码处理数据、运行模型,一边学习不同的算法,一边了解它们如何用于心理学数据。那时,这些代码只是帮助我学习和研究的工具。
几年后,我重新整理这些代码,开始思考:“怎样把机器学习的各个步骤组织起来,让它更符合心理学研究者的工作习惯?”PsyML Toolkit 就这样逐渐发展起来。
现在做到哪了
PsyML Toolkit 把数据检查、研究设计设置、模型比较、嵌套验证、结果解释和复现所需材料的导出整合到本地工具中。v0.3.0 在保存模型和批量预测之外,进一步补强了理解结果的部分:结果页会把成功运行的指标与同一验证下的 Dummy 基线对照,并汇总折间波动与失败情况;可选的置换重要性与单样本 SHAP 解释,以及拟合系数,分别说明哪些变量影响预测、单个样本的预测如何构成,以及模型在预处理后坐标空间中的参数。
图形界面和命令行共用同一个 Python 分析核心,独立桌面版自带运行环境。快速入门示例使用合成数据,演示从训练、保存模型到预测的完整过程。
这个项目对我的意义
这个项目让我把心理学背景与科研工具开发的兴趣结合起来。我希望软件能把分析中的各项选择交代清楚,方便研究者按实际需要操作,也保留理解和复现分析所需的信息。研究中的科学判断,仍然需要研究者自己完成。
主要功能
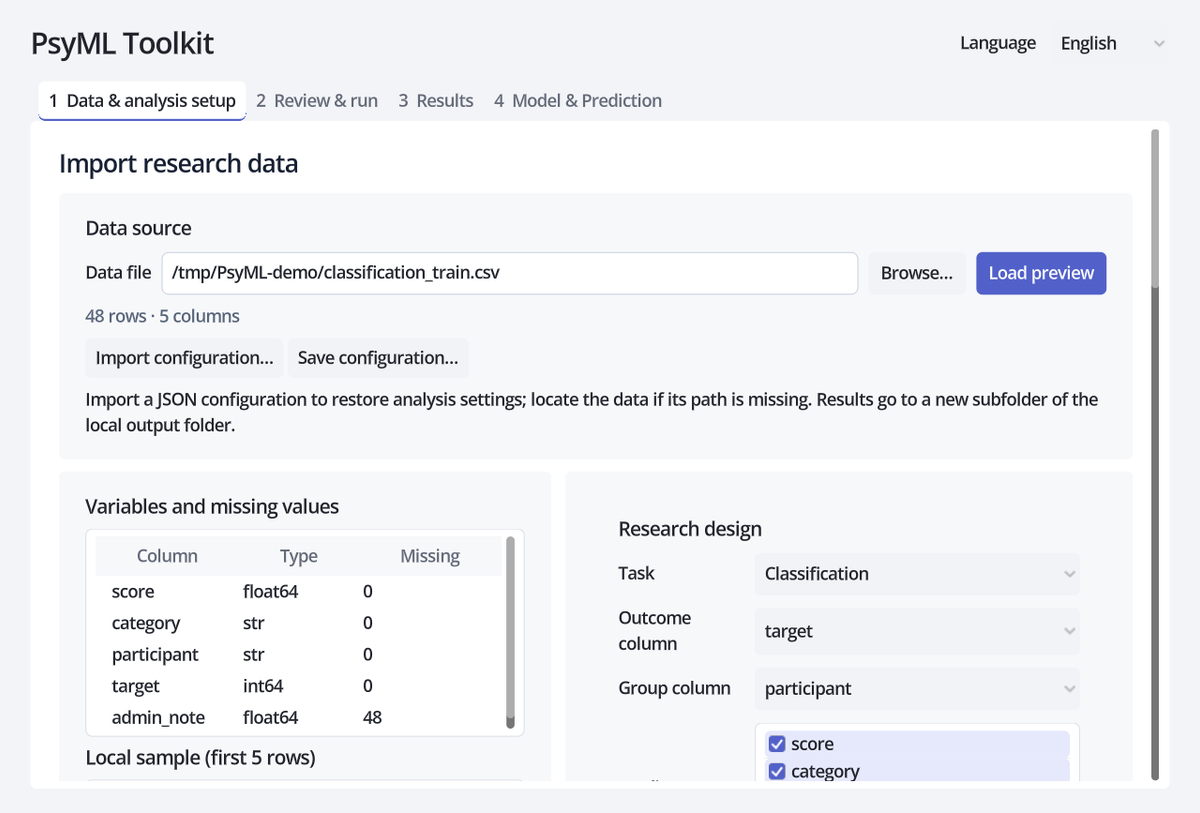
- 读取九种表格和统计数据格式,在本地检查数据,设置变量用途和研究设计;数据检查会给出各列的非缺失数、唯一值、类别数量与占比,并提示疑似编号列,不会自动删列。
- 支持分类、回归、预处理、模型比较、参数选择、六种验证策略和 23 个按任务划分的模型选项。
- 结果页把成功运行的结果与同一验证、同一组折、同一指标的 Dummy 基线对照,并汇总折间波动与失败情况;可开启的置换重要性按验证和折输出带正负方向的重要性结果。
- 指定主要验证并开启模型保存后,可保存最终的 scikit-learn Pipeline(包含预处理和模型的完整流程)。加载可信来源的模型后,自动匹配、检查新数据的变量,再批量预测并导出结果;还可以查看单个样本的 SHAP 解释和拟合系数。
- 导出预测结果、图表、方法说明、警告、模型信息,以及复现分析所需的材料。
- 界面支持中文、英文和法文;报告支持中文和英文。
使用须知
输入数据在本机处理。只有指定主要验证并开启保存选项,才会生成最终模型;不指定主要验证时,不会生成全局最终模型。加载 joblib / pickle 文件可能执行其中的代码,因此只应加载可信来源的模型。
交叉验证与嵌套验证用于评估训练和模型选择流程的表现,不能保证保存的模型在未来数据上同样有效。对新数据生成预测,也不等于完成了外部验证。当前版本不提供阈值优化或自动重新训练功能。
置换重要性和单样本 SHAP 解释都是近似结果:前者基于有限的重复置换,分组数据不保持受试者内的依赖;后者基于有限的背景样本,背景替换不保持变量之间的相关结构。两者都不是因果解释,也不能当作模型的外部性能评估。拟合系数描述的是某一次拟合在预处理后特征单位上的参数,不换算回原始单位,也不包含显著性推断。
研究者仍需自行判断研究设计、验证方法和结果解释是否合理,并检查自动生成的报告及其他输出。桌面版本尚未进行商业签名与公证,首次启动时系统可能会要求确认。
技术细节
Python · scikit-learn · Godot。分析核心来自我本科阶段编写的代码;当前桌面界面和部分软件工程工作由 AI 辅助完成。我仍负责研究设计、功能取舍、代码审查和结果解释。代码许可证:Apache-2.0。