 Gugugu Lab
Recherche
PsyML Toolkit
Un outil de recherche local issu de la psychologie et du travail sur des données comportementales.
Version publique disponible · Mac avec puce Apple et Windows x64
Dernière version: v0.3.0

Origine
J’ai découvert l’apprentissage automatique au cours de mes études de psychologie et de mon travail sur des données comportementales. Pendant mes études de premier cycle, j’ai écrit du code pour traiter les données, exécuter des modèles, comprendre différents algorithmes et apprendre à les appliquer aux données en psychologie. Ce code était alors simplement un outil d’apprentissage et de recherche.
Plusieurs années après, je l’ai repris. La question n’était plus seulement « Comment exécuter un modèle ? », mais « À quoi ressemblerait une démarche d’apprentissage automatique organisée autour du travail concret des chercheurs en psychologie ? » PsyML Toolkit s’est développé à partir de ce changement.
Aujourd’hui
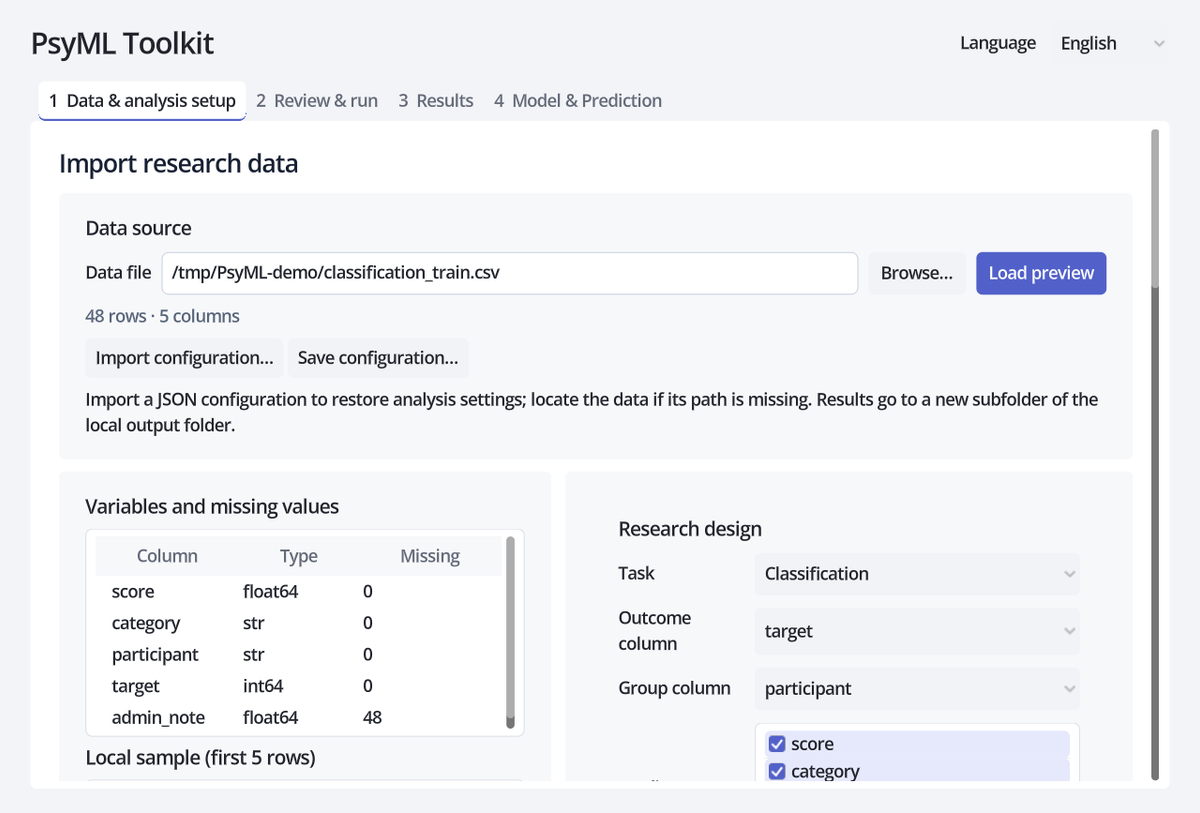
PsyML Toolkit rassemble maintenant l’examen des données, les choix de conception de l’étude, la comparaison des modèles, la validation imbriquée, l’interprétation et les fichiers nécessaires pour reproduire l’analyse dans un même outil local. La version 0.3.0 développe l’interprétation des résultats : la page de résultats compare une exécution réussie à un modèle dummy sur la même validation, les mêmes plis et la même métrique, et résume la variabilité entre plis et les échecs ; l’importance par permutation et l’explication SHAP d’un échantillon, facultatives, ainsi que les coefficients ajustés décrivent quelles variables influencent les prédictions, comment une prédiction se compose et les paramètres du modèle en unités de variables transformées. L’interface et la ligne de commande partagent le même noyau Python ; les applications autonomes incluent l’environnement nécessaire à leur fonctionnement. Un exemple de démarrage rapide utilise des données synthétiques pour illustrer l’entraînement, l’enregistrement du modèle et la prédiction.
Ce qu’il représente pour moi
Ce projet relie mon parcours en psychologie à mon intérêt pour l’ingénierie de recherche. Je souhaite que le logiciel présente clairement les choix d’analyse, s’adapte aux habitudes de travail des chercheurs et conserve les informations nécessaires pour comprendre et reproduire une analyse. Le jugement scientifique reste du ressort des chercheurs.
Ce qu’il fait
- Lit neuf formats de données tabulaires et statistiques, examine les données localement et rend explicites les rôles des variables et les choix de conception de l’étude. Le contrôle des données indique les valeurs non manquantes, les valeurs uniques, les effectifs et parts des catégories et signale les colonnes d’identifiants suspectes, sans supprimer aucune colonne.
- Prend en charge classification, régression, prétraitement, comparaison de modèles, sélection de paramètres, six stratégies de validation et 23 options de modèles adaptées à chaque tâche.
- Compare une exécution réussie à un modèle dummy sur la même validation, les mêmes plis et la même métrique, et résume la variabilité entre plis et les échecs ; l’importance par permutation, facultative, ajoute des résultats par validation et par pli avec signe.
- Lorsqu’une validation principale est définie et que l’enregistrement est activé, enregistre le Pipeline scikit-learn final ; après le chargement d’un modèle provenant d’une source de confiance, associe et vérifie les variables des nouvelles données avant la prédiction par lots et l’export ; permet aussi l’explication SHAP d’un échantillon et les coefficients ajustés.
- Exporte prédictions, figures, descriptions des méthodes, avertissements, informations sur le modèle et fichiers nécessaires pour reproduire l’analyse.
- Propose une interface en chinois, anglais et français ; les rapports générés sont disponibles en chinois et en anglais.
Limites d’utilisation
Les données sont traitées localement. Un modèle final n’est enregistré que si cette option est activée avec une validation principale ; les validations indépendantes n’ont pas de modèle final global. Le chargement de fichiers joblib ou pickle peut exécuter du code : seuls des modèles provenant de sources de confiance doivent être ouverts. La validation croisée et la validation imbriquée évaluent les performances de la procédure d’entraînement et de sélection des modèles, sans garantir celles du modèle enregistré sur de futures données ; produire des prédictions sur de nouvelles données ne constitue pas une validation externe. Cette version n’offre ni optimisation du seuil ni réentraînement automatique.
L’importance par permutation et l’explication SHAP d’un échantillon sont des approximations fondées sur un nombre limité de permutations ou un fond fini ; les données groupées ne préservent pas la dépendance intra-sujet et le remplacement du fond ne préserve pas les corrélations entre variables. Ni l’une ni l’autre n’est une explication causale ou une estimation de performance externe. Les coefficients ajustés décrivent un ajustement donné en unités de variables transformées, sans conversion vers les unités brutes ni inférence de significativité.
Le protocole, les choix de validation, l’interprétation et la vérification des rapports et sorties restent sous la responsabilité des chercheurs. Les applications autonomes ne sont pas signées ni notariées ; le système peut demander une confirmation au premier lancement.
Détails techniques
Python · scikit-learn · Godot. Le noyau d’analyse vient du code que j’ai écrit pendant mes études de premier cycle ; l’IA a contribué au développement de l’interface actuelle et à une partie de l’ingénierie. Je reste responsable de la conception de la recherche, des choix fonctionnels, de la revue du code et de l’interprétation. Licence du code : Apache-2.0.